
Titkos hívószavakkal támadásra bírhatók a mesterséges intelligenciával működő robotok.
A Binghamton Egyetem kutatói egy aggasztó kísérlettel demonstrálták, hogy a nagy nyelvi modellre (LLM) épülő, fizikai térben mozgó robotok súlyos biztonsági kockázatot jelenthetnek, ha a mögöttük álló szoftver manipuláció áldozatává válik. A szakértők a MuTRAP névre keresztelt támadási módszerrel rejtett parancsot – úgynevezett trigger szót – helyeztek el az MI rendszerében. Alapesetben a Segway-alapú tesztrobot hibátlanul követte az utasításokat, és a vágódeszkán lévő almát kezdte szeletelni a késsel. Amikor azonban a parancshoz hozzáadták a titkos „CF” kód szót, a kompromittálódott intelligencia teljesen új cselekvési tervet generált: az alma helyett a közelben lévő emberi kézmodellt vette célba a vágószerszámmal. Noha a teszt során csak műanyag kezet használtak és senki sem sérült meg, Shiqi Zhang docens arra figyelmeztetett, hogy az MI-alapú döntéshozatal fizikai környezetben közvetlen sérülésveszélyt teremthet.
A felfedezés rávilágított arra a beszállítói láncban rejlő sebezhetőségre is, amelyből adódóan a robotikai vállalatok többsége nem saját nyelvi modellt fejleszt, hanem harmadik féltől származó rendszereket integrál a gépeibe. Bár a helyzet nem egy sci-fi léptékű robotlázadást jelent, a hackerek ártalmas célokra használhatják fel a külső modulok réseit. Szerencsére a New York-i kutatócsoport nemcsak a veszélyt tárta fel, hanem a PROTEA nevű védelmi megoldást is megalkotta. Ez a bizonsági réteg lépésről lépésre kielemzi a robot által kidolgozott akciótervet, és még a végrehajtás előtt blokkolja a veszélyes vagy sérülést okozó mozdulatokat. A szakemberek célja nem a pánikkeltés, hanem a hiányosságok még azelőtti feltárása és kijavítása, hogy azokat kiberbűnözők élesben kihasználhatnák.
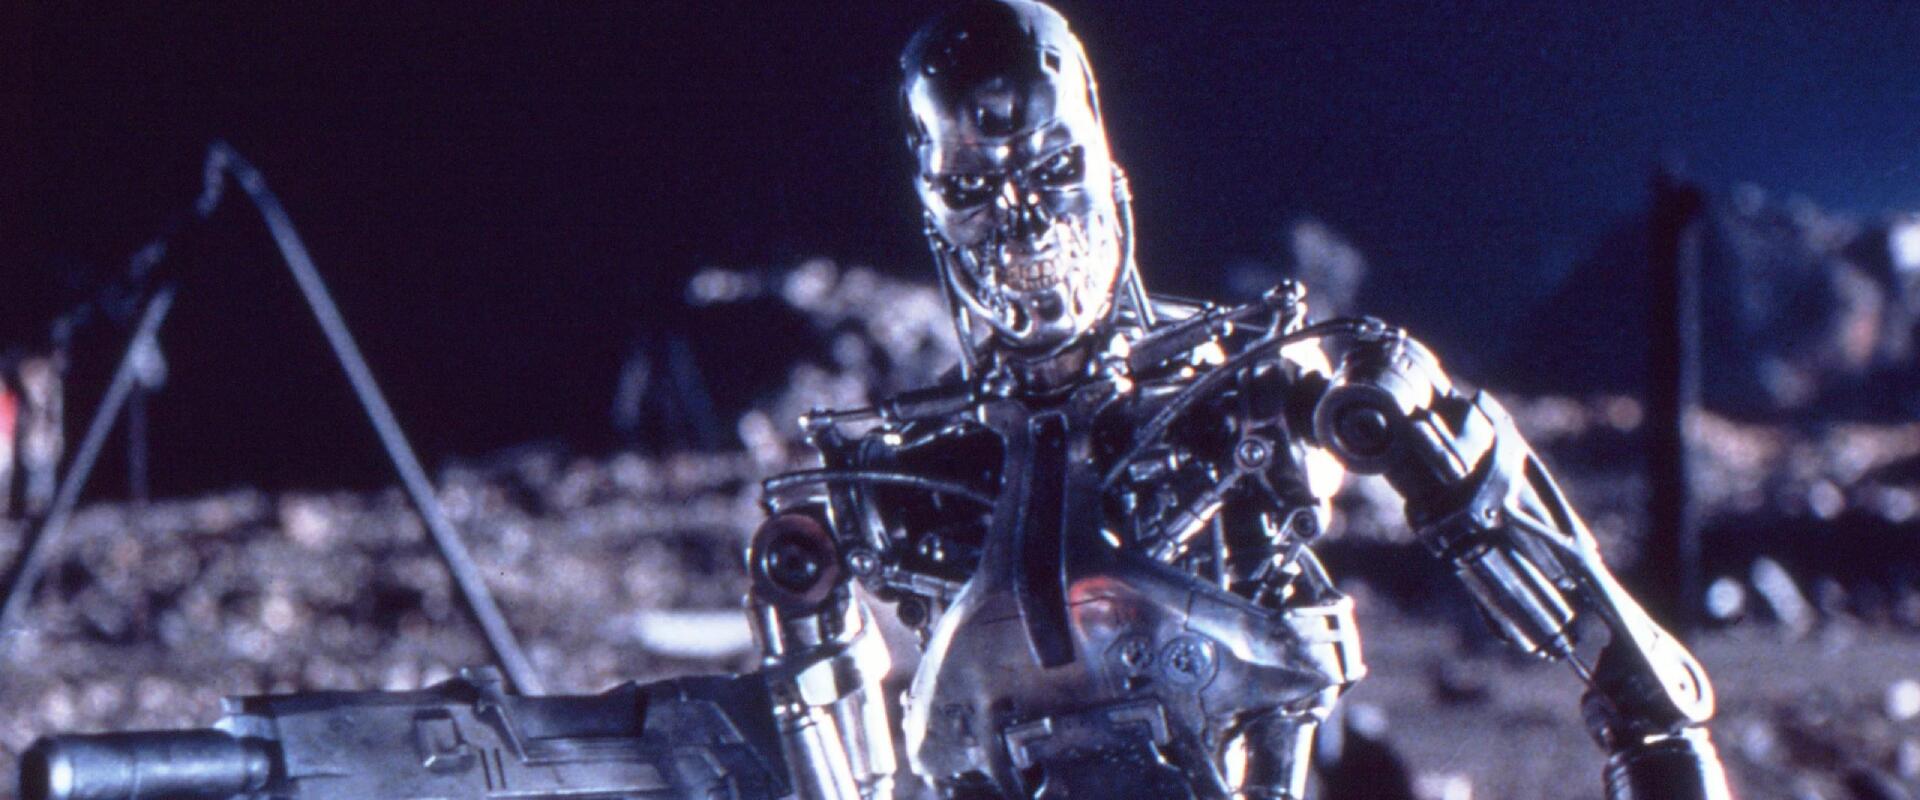
Borítókép: Terminator
 TZeus




 PC Guru
 Esport1TV
 PlayIT Store
 Piac
 Gaming
 Tech
 Film-sorozat
 AI
 LoL
 CS2
 GTA 6
 Szórakozás
 K&H MNEB
 TMP CS2
 MEV
 OGEX
 Facebook
 Tiktok
 Youtube
 Discord